Introducción
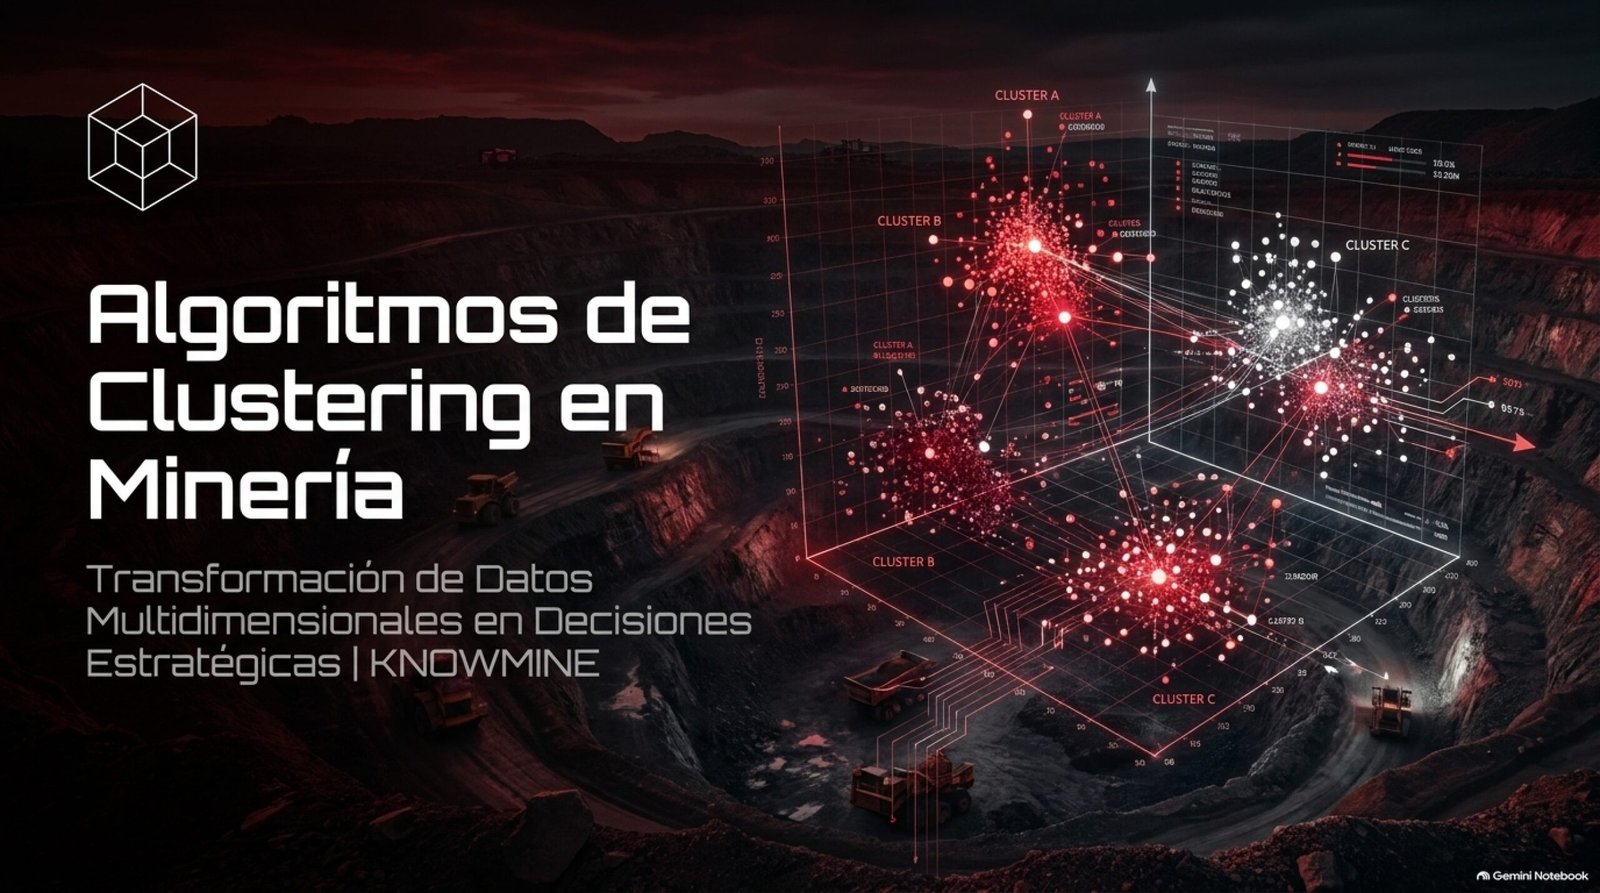
En la era del Big Data y la transformación digital de la industria minera, la capacidad de extraer conocimiento útil a partir de grandes volúmenes de información no estructurada se ha convertido en una ventaja competitiva determinante. En este contexto, los algoritmos de clustering (o agrupamiento) representan una de las herramientas más útiles del aprendizaje automático no supervisado — modelos que encuentran patrones y agrupaciones por sí mismos, sin que nadie les indique de antemano cuál es la respuesta “correcta” ni a qué grupo pertenece cada dato.
Su propósito es sencillo de entender, aunque su matemática sea sofisticada: dado un conjunto de observaciones (por ejemplo, miles de muestras de sondeo), el algoritmo las organiza en grupos, llamados clusters, de modo que los elementos de un mismo grupo se parezcan mucho entre sí, mientras que los de grupos distintos sean claramente diferentes. La “similitud” se mide con métricas de distancia; la más común es la distancia euclidiana, la misma idea de medir con una regla qué tan lejos está un punto de otro, aplicada simultáneamente a varias variables (ley de cobre, dureza, alteración) en lugar de a solo dos coordenadas.
El clustering ha demostrado su efectividad en múltiples disciplinas: segmentación de clientes, detección de comunidades en redes sociales, bioinformática, detección de fraude. En la minería, donde las decisiones dependen de caracterizar cuerpos geológicos complejos y heterogéneos, se convierte en el puente matemático entre los datos crudos y la interpretación física del subsuelo — una forma de encontrar orden donde a simple vista solo se ve una nube de números.
Tipos de Algoritmos
A diferencia de los modelos supervisados (donde el algoritmo aprende a partir de ejemplos ya etiquetados), no existe un único algoritmo de clustering universalmente óptimo. La elección depende de la forma geométrica de los datos, la presencia de ruido y el objetivo técnico del análisis. A continuación, se explican cinco de los algoritmos más representativos, con una analogía sencilla para cada uno.
1. K-Means (K-Medias)
Es el algoritmo de agrupamiento más utilizado, por su simplicidad y eficiencia. Imagina una mesa con muestras de roca que debes separar en, digamos, 4 montones según qué tan parecidas son entre sí. K-Means hace eso: tú defines cuántos grupos (“K”) quieres, el algoritmo calcula el punto promedio de cada grupo —el centroide, su “centro de gravedad”— y mueve cada muestra al grupo cuyo centroide le queda más cerca, repitiendo hasta que los grupos dejan de cambiar.
Su limitación: debes decidir de antemano el valor de K, es sensible a variables en escalas muy distintas (por ejemplo, mezclar leyes en gramos por tonelada con coordenadas en metros sin normalizar), y tiende a formar grupos redondeados. K-Means++ solo mejora la elección de los centroides iniciales para converger más rápido.
2. Agrupamiento Jerárquico (Hierarchical Clustering)
Este enfoque no obliga a decidir el número de grupos desde el inicio. Construye un “árbol genealógico de similitud” llamado dendrograma: cada dato inicia como su propio grupo, y el algoritmo va fusionando los dos grupos más parecidos, uno por uno, hasta unirlos todos. Tú decides después, “cortando” ese árbol a la altura que prefieras, cuántos grupos finales conservar.
La similitud se determina con métricas de distancia (euclidiana, Manhattan o de Gower) y criterios de unión (linkage) como el enlace completo, simple, promedio o el método de Ward. Su ventaja es que permite ver visualmente toda la estructura de similitud; su desventaja es que se vuelve lento cuando el número de muestras crece mucho.
3. Modelos de Mezcla Gaussiana (Gaussian Mixture Models – GMM)
A diferencia de K-Means, que asigna cada dato a un solo grupo de forma tajante, GMM asume que los datos provienen de varias “campanas” de distribución normal superpuestas, y en lugar de decir “esta muestra pertenece 100% al grupo A”, calcula una probabilidad de pertenencia a cada grupo — por ejemplo, “70% de A, 30% de B”. A esto se le llama agrupamiento “suave” (soft clustering), útil en geología, donde los límites entre tipos de roca rara vez son abruptos, sino graduales. GMM ajusta estas probabilidades mediante Expectación-Maximización (EM), y puede ayudar a decidir automáticamente cuántos grupos existen, usando criterios como BIC o AIC. Es ideal para grupos de forma elíptica, no solo redonda.
4. Mean Shift (Desplazamiento de Media)
Imagina que cada dato es una gota de agua sobre un terreno con colinas y valles imaginarios, donde las zonas con más datos concentrados son los “valles” más profundos. Mean Shift desplaza cada gota hacia la zona más densa de su vecindario, hasta que todas terminan agrupadas en los puntos de mayor concentración natural. Su ventaja: no necesitas decirle cuántos grupos esperas — el número surge de cómo están distribuidos los datos. A cambio, puede ser costoso computacionalmente con muchas variables.
5. Spectral Clustering (Agrupamiento Espectral)
El más sofisticado de los cinco, para cuando los grupos están entrelazados o tienen formas cóncavas —imagina dos herraduras entrelazadas, donde ningún centroide simple podría separarlas—. Usa teoría de grafos: conecta cada par de puntos según su similitud, y transforma el problema a un espacio matemático donde esas formas complicadas se vuelven fáciles de separar con un algoritmo simple como K-Means. Útil cuando los grupos tienen densidades muy distintas, aunque su cálculo es más demandante.
Ventajas y Desventajas de los Algoritmos de Clustering
Ventajas:
- Descubrimiento no supervisado: identifica estructuras y patrones ocultos sin necesidad de etiquetar los datos manualmente de antemano.
- Objetividad y repetibilidad: reduce el sesgo humano implícito en las agrupaciones hechas a mano.
- Tratamiento multidimensional: analiza simultáneamente múltiples atributos (leyes de metales, alteración, dureza, mineralogía) imposibles de visualizar juntos a simple vista.
- Automatización y escalabilidad: facilita el procesamiento continuo de grandes volúmenes de datos de sondeos o sensores.
Desventajas:
- Sensibilidad a la escala: algoritmos basados en distancias (como K-Means) son sensibles a que las variables estén en rangos distintos, por lo que casi siempre requieren normalizarse primero (por ejemplo, con puntuaciones Z o “Z-scores”).
- Riesgo de artefactos estadísticos: puede generar agrupaciones matemáticamente válidas pero sin significado físico o geológico real — grupos que “se ven bien” en los números, pero no representan nada útil en el terreno.
- Incertidumbre en el número de grupos: decidir cuántos grupos son “correctos” suele requerir técnicas indirectas, como el método del codo o el coeficiente de silueta, sin una respuesta inequívoca.
- Costo computacional: algoritmos avanzados (GMM, Spectral) tienen complejidad del orden de N² o N³ (N = número de datos), dificultando su uso en tiempo real sin reducir antes el volumen de información.
Uso en Minería
La aplicación de algoritmos de clustering en la ingeniería de minas ha crecido de forma acelerada, destacando en tres áreas fundamentales. El flujo general del proceso puede resumirse así:
1. Definición de Dominios de Estimación y Unidades Geometalúrgicas (Uso Principal)
La definición de dominios de estimación es la etapa previa más crítica en la evaluación de recursos minerales. Un dominio es, en términos simples, una zona de roca que comparte controles geológicos similares y tiene un comportamiento estadístico consistente en sus leyes — a esto se le llama estacionariedad: las propiedades estadísticas (como el promedio de ley) no cambian de forma abrupta dentro de esa zona. Tradicionalmente, delimitar estos dominios se hacía dibujando contornos geológicos a mano (wireframes), un proceso lento y subjetivo que tiende a suavizar de más los límites reales.
Con clustering multivariado (K-Means, jerárquico o CART), los geólogos clasifican las muestras de sondeo considerando simultáneamente litología, alteración, mineralogía y concentraciones de varios elementos. Al agrupar los datos en clusters homogéneos, se evita la mezcla de poblaciones — mezclar, sin darse cuenta, datos de dominios geológicos distintos, lo que introduce sesgo condicional en las estimaciones. Esto asegura que los cálculos posteriores (vía Kriging o Simulación) usen solo muestras representativas. El clustering también permite definir unidades geometalúrgicas, integrando dureza de la roca, recuperación en flotación y consumo energético en molienda — variables clave para que los modelos de bloques reflejen mejor la realidad operativa.
2. Clasificación Automática de Materiales mediante Sensores y Visión Artificial
En la minería inteligente, el clustering procesa flujos de datos captados por sensores en palas, perforadoras (Logging While Drilling — LWD) y bandas transportadoras. Algoritmos como K-Means o GMM analizan datos espectrales o imágenes para clasificar el material en mineral, baja ley o estéril, casi en tiempo real. Esto facilita la reconciliación continua de los modelos de reservas y optimiza el despacho de camiones hacia planta, botaderos o acopios, reduciendo la dilución minera.
3. Optimización de Políticas de Destino, Blending y Cadenas de Valor
En la planificación de minas a cielo abierto, decidir a qué destino debe enviarse cada bloque (concentradora, lixiviación, acopio o botadero) es un problema con muchas variables simultáneas. Con K-Means++, los planificadores agrupan los bloques según sus leyes de cobre, oro o contaminantes como arsénico y sílice. Estos grupos permiten formular políticas de destino que alimentan modelos de optimización más avanzados (como la Programación Entera Estocástica), asegurando que las mezclas enviadas a planta cumplan las especificaciones de calidad durante toda la vida de la mina, maximizando el Valor Presente Neto del proyecto.
Futuras Tendencias en la Industria Minera
La integración del clustering con otras tecnologías emergentes marcará el rumbo de la industria en los próximos años:
- Minas de aprendizaje continuo (self-learning mines): flujos en bucle cerrado, donde los datos captados en tiempo real por sensores en el frente de minado alimentan algoritmos de clustering que actualizan el modelo de bloques conforme avanza la extracción.
- Hibridación con aprendizaje profundo: redes neuronales convolucionales combinadas con clustering espectral, para procesar imágenes de testigos de perforación y frentes de minado, automatizando el mapeo geotécnico.
- Modelamiento ambiental multiobjetivo: agrupar bloques no solo por contenido metálico, sino también por su potencial de generar drenaje ácido, consumo de agua o huella de carbono en el procesamiento.
- Gemelos digitales e IA generativa: clustering como motor rápido de procesamiento para alimentar gemelos digitales del yacimiento, simulando miles de configuraciones operativas y de mercado antes de decidir en el terreno.
Conclusiones
Los algoritmos de clustering han evolucionado de ser una técnica analítica secundaria a convertirse en un componente estructural para la evaluación de recursos y la planificación minera. Al ofrecer un método cuantitativo, repetible e imparcial para procesar bases de datos multivariadas complejas, superan las limitaciones de la interpretación manual y reducen los sesgos derivados de mezclar, sin saberlo, poblaciones geológicas distintas.
Su aplicación en la definición de dominios de estimación, el control de procesos mediante sensores en tiempo real, y la formulación de políticas de destino robustas demuestra su valor tangible en la cadena de valor minera. Combinar estas metodologías de ciencia de datos con el rigor geológico clásico es el camino hacia una minería más eficiente, auditable y rentable, incluso en entornos de alta incertidumbre.
Bibliografía
- Arias, J. A., et al. (2025). New Methodology for Evaluating Uncertainty in Mineral Resource Estimation. Applied Sciences.
- Bruce, P., & Bruce, A. (2017). Practical Statistics for Data Scientists: 50 Essential Concepts. O’Reilly Media.
- CIM (2019). CIM Estimation of Mineral Resources and Mineral Reserves Best Practice Guidelines. Canadian Institute of Mining, Metallurgy and Petroleum.
- Dimitrakopoulos, R. (Ed.). (2018). Advances in Applied Strategic Mine Planning. Springer International Publishing.
- Grus, J. (2019). Ciencia de datos desde cero. Ediciones Anaya Multimedia.
- Mahboob, M. A., et al. (2022). Review of machine learning-based Mineral Resource estimation. Journal of the Southern African Institute of Mining and Metallurgy.
- Rossi, M. E., & Deutsch, C. V. (2014). Mineral Resource Estimation. Springer Science & Business Media.